Data Encryption Standard
〈컴퓨터정보보안〉 수업 노트
DES는 1970년대 개발되어 미 연방 정부 표준으로 채택된 블록 암호화 방법이다. IBM의 Lucifer 방법을 기반으로 설계되었다.
64비트의 평문 블록을 16라운드의 Feistel 구조로 암호화한다. 키 역시 블록 크기와 동일한 64비트이나 키의 유효한 부분은 56비트인데, 남은 8비트는 패러티 비트이다.
- 블록 길이: 64비트
- 입력 키 길이: 64비트
- 유효 키 길이: 56비트
- 라운드 수: 16
- 라운드 별 서브키 길이: 48비트
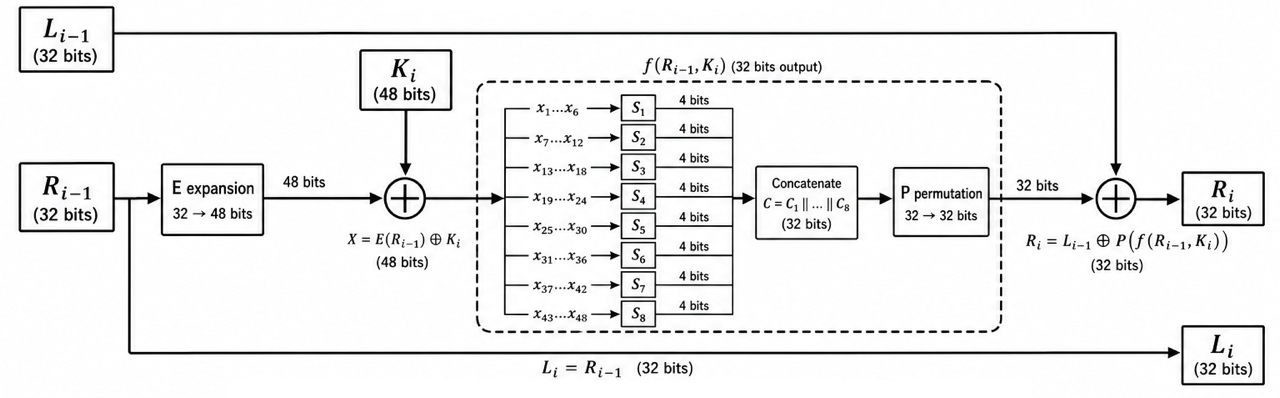
전체 과정
초기화
| 이전 | 이후 |
|---|---|
| 64비트 | 각 32비트 * 2 |
우선 64비트의 평문 $M$ 은 초기 순열(initial permutation) $IP$ 를 거쳐, 32비트 왼쪽 블록 $L_0$ 과 32비트 오른쪽 블록 $R_0$ 로 나눈다.
1
2
3
4
5
6
7
8
57 49 41 33 25 17  9  1
59 51 43 35 27 19 11  3
61 53 45 37 29 21 13  5
63 55 47 39 31 23 15  7
56 48 40 32 24 16  8  0
58 50 42 34 26 18 10  2
60 52 44 36 28 20 12  4
62 54 46 38 30 22 14  6
Fiestel 라운드
| 이전 | 이후 |
|---|---|
| 각 32비트 * 2 | 각 32비트 * 2 |
각 라운드 $i = 1, 2, …, 16$ 에 대해, DES는 다음과 같은 과정을 거친다.
\[L_i = R_{i - 1}\] \[R_i = L_{i - 1} \oplus F(R_{i - 1}, K_i)\]이전 라운드의 오른쪽 블록 $R_{i - 1}$ 은 새로운 왼쪽 블록 $L_i$ 이 되고, 이전 라운드의 왼쪽 블록 $L_{i - 1}$ 은 라운드 함수 $F$ 의 출력과 함께 새로운 오른쪽 블록 $R_i$ 를 생성하는데 사용된다.
출력
| 이전 | 이후 |
|---|---|
| 각 32비트 * 2 | 각 32비트 * 2 |
16개의 라운드를 반복한 후, DES는 마지막 블록 $L_{16}$ 과 $R_{16}$ 을 결합하여 64비트의 암호문을 생성한다.
\[C = IP^{-1}(R_{16} \vert \vert L_{16})\]$IP^{-1}$ 은 초기 순열의 역순열로, 암호화 과정에서 사용된 재배치 처리를 되돌린다. 이 과정을 통해 평문 $M$ 은 암호문 $C$ 로 변환된다.
라운드 $F$
DES는 다음과 같은 라운드를 반복한다.
- 32비트 오른쪽 블록 $R_{i - 1}$ 에 대해, 48비트로 확장하여 $E(R_{i - 1})$ 를 생성한다.
- 48비트 서브키 $K_i$ 와 XOR 연산을 수행한다.
- 48비트 결과를 S-box 연산하여 32비트로 축소한다.
- 32비트 결과를 P-box 연산하여 비트를 재배열한다.
확장 재배치 $E$
| 이전 | 이후 |
|---|---|
| 각 32비트 * 2 | 32비트(왼쪽 블록), 48비트(오른쪽 블록) |
\1. 32비트 오른쪽 블록 $R_{i - 1}$ 에 대해, 48비트로 확장하여 $E(R_{i - 1})$ 를 생성한다.
$E(x)$ 는 아래와 같은 인덱스로 정렬된 입력 32비트 값에 대해
1
2
 0  1  2  3  4  5  6  7  8  9 10 11 12 13 14 15
16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
아래와 같이 인덱스를 섞어 48비트로 확장한다.
1
2
3
4
5
6
7
8
31  0  1  2  3  4
 3  4  5  6  7  8
 7  8  9 10 11 12
11 12 13 14 15 16
15 16 17 18 19 20
19 20 21 22 23 24
23 24 25 26 27 28
27 28 29 30 31  0
S-box
| 이전 | 이후 |
|---|---|
| 32비트(왼쪽 블록), 48비트(오른쪽 블록) | 각 32비트 * 2 |
\3. 48비트 결과를 S-box 연산하여 32비트로 축소한다.
S-box는 6비트 값을 4비트로 매핑한다. 8개의 S-box가 존재하며, 각 S-box는 4행 16열의 테이블로 구성된다. 6비트 입력 값의 첫 번째와 마지막 비트로 행을 결정하고, 나머지 4비트로 열을 결정한다. 해당 위치의 값을 출력으로 사용한다.
이러한 표가 서로 다른 내용으로 8개 존재하고, 각 6비트 별로 서로 다른 표를 사용한다. 6비트 입력 값 $b_1 b_2 b_3 b_4 b_5 b_6$ 에 대해,
row = input[0], input[5]col = input[1], input[2], input[3], input[4]
로 행과 열을 결정해 4비트 출력 값, 합해서 32비트(8개의 4비트 값) 값을 얻는다.
1
2
3
4
5
6
행\열  0  1  2  3  4  5  6  7  8  9 10 11 12 13 14 15
----------------------------------------------------------------
  0   14  4 13  1  2 15 11  8  3 10  6 12  5  9  0  7
  1    0 15  7  4 14  2 13  1 10  6 12 11  9  5  3  8
  2    4  1 14  8 13  6  2 11 15 12  9  7  3 10  5  0
  3   15 12  8  2  4  9  1  7  5 11  3 14 10  0  6 13
바이너리 표
00 | 0000 0001 0010 0011 0100 0101 0110 0111 1000 1001 1010 1011 1100 1101 1110 1111------------------------------------------------------------------------------------00 | 1110 0100 1101 0001 0010 1111 1011 1000 0011 1010 0110 1100 0101 1001 0000 011101 | 0000 1111 0111 0100 1110 0010 1101 0001 1010 0110 1100 1011 1001 0101 0011 100010 | 0100 0001 1110 1000 1101 0110 0010 1011 1111 1100 1001 0111 0011 1010 0101 000011 | 1111 1100 1000 0010 0100 1001 0001 0111 0101 1011 0011 1110 1010 0000 0110 1101
P-box
| 이전 | 이후 |
|---|---|
| 각 32비트 | 각 32비트 |
\4. 32비트 결과를 P-box 연산하여 비트를 재배열한다.
P-box는 아래와 같은 인덱스로 정렬된 입력 32비트 값에 대해
1
2
3
4
 0  1  2  3  4  5  6  7
 8  9 10 11 12 13 14 15
16 17 18 19 20 21 22 23
24 25 26 27 28 29 30 31
아래와 같이 재배치한다.
1
2
3
4
15  6 19 20 28 11 27 16
 0 14 22 25  4 17 30  9
 1  7 23 13 31 26  2  8
18 12 29  5 21 10  3 24
이 재배열함으로써, S-box의 출력이 다음 라운드에서 여러 S-box의 입력에 영향을 주도록 해, 확산을 발생시킨다.
서브키 생성
| 이전 | 이후 |
|---|---|
| 64비트 키 | 48비트 서브키 * 16 |
\2. 48비트 서브키 $K_i$ 와 XOR 연산을 수행한다.
2번 과정에서 사용하는 서브키는 원본 64비트(패러티 제외 56비트) 키를 16개의 48비트 키로 파생해 사용한다.
- 56비트 키
- 28비트 $LK_0$ 와 28비트 $RK_0$ 로 분리
- 라운드마다 왼쪽 순환 이동
- 28비트 $LK_i$ 와 28비트 $RK_i$
- 선택 및 재배열
- 48비트 서브키 $K_i$
| 이전 | 이후 |
|---|---|
| 64비트 | 56비트 |
64비트 입력 키에서 각 바이트의 마지막 비트1는 패러티 비트이다. 이를 제거하고 아래와 같이 정렬된 56비트 키에 대해
| 이전 | 이후 |
|---|---|
| 56비트 | 28비트 * 2 |
1 인덱스 7, 15, 23, 31, 39, 47, 55, 63 비트
1
2
3
4
5
6
7
 0  1  2  3  4  5  6  7
 8  9 10 11 12 13 14 15
16 17 18 19 20 21 22 23
24 25 26 27 28 29 30 31
32 33 34 35 36 37 38 39
40 41 42 43 44 45 46 47
48 49 50 51 52 53 54 55
Left half 키 LK 와 Right half 키 RK 를 아래와 같이 28비트씩 나눈다.
LK:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
2-1 → |  0
3-1 → |  8  1
4-1 → | 16  9  2
      | 24 17 10  3
      | 32 25 18 11  4
      | 40 33 26 19 12  5
      | 48 41 34 27 20 13  6
  1 → |    49 42 35 28 21 14  7
2-2 → |       50 43 36 29 22 15
3-2 → |          51 44 37 30 23
4-2 → |             52 45 38 31
      |                53 46 39
      |                   54 47
      |                      55
1
2
3
4
49 42 35 28 21 14  7
 0 50 43 36 29 22 15
 8  1 51 44 37 30 23
16  9  2 52 45 38 31
RK:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
      |  0
      |  8  1
      | 16  9  2
  7 → | 24 17 10  3
  6 → | 32 25 18 11  4
  4 → | 40 33 26 19 12  5
  2 → | 48 41 34 27 20 13  6
      |    49 42 35 28 21 14  7
      |       50 43 36 29 22 15
      |          51 44 37 30 23
      |             52 45 38 31
  5 → |                53 46 39
  3 → |                   54 47
  1 → |                      55
1
2
3
4
55 48 41 34 27 20 13
 6 54 47 40 33 26 19
12  5 53 46 39 32 25
18 11  4 24 17 10  3
| 이전 | 이후 |
|---|---|
| 28비트 * 2 | 28비트 * 2 |
각 라운드 $i = 1, 2, …, 16$ 에서, $LK$ 와 $RK$ 를 왼쪽으로 1비트 또는 2비트 순환 이동시킨다. 이동한 결과를 $LK_i$, $RK_i$ 로 표현한다.
$LK_{i-1}$, $RK_{i-1}$ 에 대해, $LK_i$, $RK_i$ 는 각 인덱스에 대해 아래와 같이 정의된다.
- $LK_i = LK_{i-1}$ 의 비트를 왼쪽으로 $r_i$ 비트 이동
- $RK_i = RK_{i-1}$ 의 비트를 왼쪽으로 $r_i$ 비트 이동
- 라운드 1, 2, 9, 16: $r_i = 1$
- 나머지 라운드: $r_i = 2$
| 이전 | 이후 |
|---|---|
| 28비트(서브키 생성 배열) * 2 | 24비트 (서브키의 반쪽) * 2 28비트(서브키 생성 배열) * 2 |
또한 각 라운드에서
- $LK$ 의 인덱스 8, 17, 21, 24 비트를 제외하고 비트를 재배열해 서브키의 반쪽 생성
- $RK$ 의 인덱스 6, 9, 14, 25 비트를 제외하고 비트를 재배열해 서브키의 반쪽 생성 한 후 결과를 이어붙인다.
LK의 선택 표:
1
2
13 16 10 23  0  4  2 27 14  5 20  9
22 18 11  3 25  7 15  6 26 19 12  1
RK의 선택 표:
1
2
12 23  2  8 18 26  1 11 22 16  4 19
15 20 10 27  5 24 17 13 21  7  0  3
복호화
복호화는 서브키를 역순으로 적용해 원래의 평문을 복구한다. Feistel 구조에서는 XOR 연산의 대칭성을 이용해 이전 라운드의 블록을 복구할 수 있다.
\[C = IP^{-1}(R_{16} \vert \vert L_{16})\] \[L_{i - 1} = R_i\] \[R_{i - 1} = L_i \oplus F(R_i, K_i)\] \[P = (L_0, R_0)\]따라서 라운드 함수 $F$ 와 S-box의 역함수는 필요하지 않다.
Triple DES
DES는 키를 전수조사하는 것만이 유일한 공격 방법이지만, 오늘날에는 56비트는 전수조사에 충분히 짧은 길이이기 때문에, DES를 효율적으로 확장하는 방법이 고안된다.
\[C_1 = E(P, K_1)\]만약 DES를 2번 적용한다면 56비트 DES 키를 두 개 사용해 112비트 키를 사용한 것과 같다.
\[C_2 = D(C_1, K_2) = E(E(P, K_1), K_2)\]하지만 만약 공격자가 known plaintext 공격을 수행한다면 $E(P, K_1)$ 에 대해 사전 계산 표를 만들어두고 $D(C_2, K_2)$ 를 계산해, 사전 계산 표가 등장하는 지 확인하여 $K_1$, $K_2$ 를 찾을 수 있다.
$E(E(E()))$ 과정이 아니라 $E(D(E()))$ 과정을 사용하는 것은 하위 호환을 위해서이다. 만약 Tritple DES를 지원하지 않는 시스템이 Triple DES를 지원하는 시스템과 데이터를 교환한다면 $K_1 = K_2 = K$ 로 설정해 $E(D(E(P, K), K), K) = E(P, K)$ 과정을 수행할 수 있다.