Symmetric Key Cipher
〈컴퓨터정보보안〉 수업 노트
Cipher 과정에서 평문을 어떤 단위로 암호화하는지에 따라, Cipher는 혼동(i.e. one-time pad)만 발생시킬수도, 혼동과 확산을 모두 발생(i.e. codebook)시킬 수도 있었다.
전자의 대표적인 예 one-time pad와 후자의 대표적인 예 codebook 방법을 일반화하여, 암호화 과정을 Stream Cipher와 Block Cipher로 나누어 설명할 수 있다.
| Stream Cipher | Block Cipher | |
|---|---|---|
| 키 | 상대적으로 짧음 긴 키 스트림(keystream)으로 늘려서 사용 | 코드북의 길이에 의해 결정 각 키는 서로 다른 코드북을 사용 |
| 암호화 원리 | 혼동 | 혼동 + 확산 |
Stream Cipher
스트림 암호화는 이전에는 널리 사용되었지만, 오늘날에는 부채널 공격 등 공격 기법이 발전하여 그렇게 인기있게 사용되지는 않는다.
A5/1
A5/1은 3개의 선형 피드백 시프트 레지스터(LFSR)를 사용하여 64비트 키를 228비트의 키 스트림으로 확장하는 방식으로 동작한다. 이 방법에서는 세 개의 레지스터에 대해 다음과 같이 비트 값을 선택해 사용하는 것으로 정의된다.
- $X$ : 19비트 $(x_0, x_1, x_2, …, x_{18})$
- $Y$ : 22비트 $(y_0, y_1, y_2, …, y_{21})$
- $Z$ : 23비트 $(z_0, z_1, z_2, …, z_{22})$
이렇게 하여 주어진 키 스트림 $S=(s_0, s_1, …)$ 과 평문 $P=(p_0, p_1, …)$ 에 대해, 암호문 $C=(c_0, c_1, …)$ 은 $c_i = p_i \oplus s_i$ 의 관계로 생성된다.
각 반복 과정에서 최빈값 $\text{maj}$ 로 정의되는 $m=\text{maj}(x_{8}, y_{10}, z_{10})$ 을 고려할 수 있는데,
- $x_8 = m$ 이면 $X$ 레지스터를 한 칸 이동
- $y_{10} = m$ 이면 $Y$ 레지스터를 한 칸 이동
- $z_{10} = m$ 이면 $Z$ 레지스터를 한 칸 이동
시킨다. 이렇게 하면 키스트림의 비트는 $x_{18} \oplus y_{21} \oplus z_{22}$ 의 관계로 생성된다.
구체적인 시프트는 다음과 같다.
- $x_8 = m$ 일 때, $X$ 레지스터를 한 칸 이동하면
- $x_0 = x_{13} \oplus x_{16} \oplus x_{17} \oplus x_{18}$
- $x_i = x_{i - 1}$ for $i = 18, 17, …, 1$
- $y_{10} = m$ 이면 $Y$ 레지스터를 한 칸 이동
- $y_0 = y_{20} \oplus y_{21}$
- $y_i = y_{i - 1}$ for $i = 21, 20, …, 1$
- $z_{10} = m$ 이면 $Z$ 레지스터를 한 칸 이동
- $z_0 = z_{7} \oplus z_{20} \oplus z_{21} \oplus z_{22}$
- $z_i = z_{i - 1}$ for $i = 22, 21, …, 1$
$x_0$, $y_0$, $z_0$, 시프트한 결과로 빈 자리에 대해서는 단순 순환 시프트를 적용하지 않았다. 단순 순환 시프트 시에는 짧은 순환 패턴을 반복하게 되어, 키스트림 생성에 불리하기 때문이다.
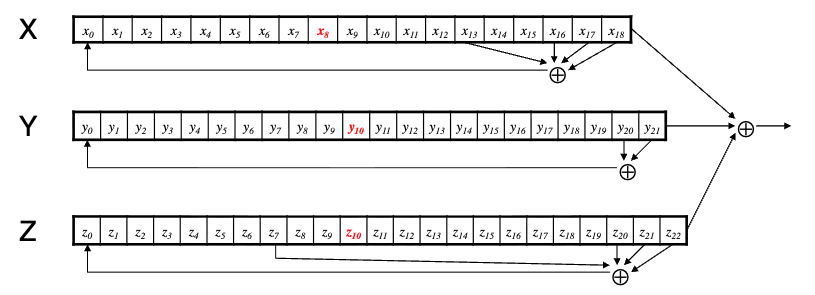
또한 시프트 후에는 $X$, $Y$, $Z$ 레지스터의 비트들을 XOR 연산하는데, 이때 XOR 연산의 결과를 키스트림의 비트로서 사용한다.
\[\text{for iteration }j, x_{18} \oplus y_{21} \oplus z_{22} = s_j\] \[c_j = p_j \oplus s_j\]시프트 레지스터
시프트 연산은 비용이 가장 저렴한 연산이고, 시프트 레지스터 역시 가장 단순하고 저렴한 하드웨어 중 하나이다. 때문에, A5/1과 같이 시프트 연산을 기반으로 하는 방법은 고속 암호화 처리에 용이했다.
오늘날에는 하드웨어 성능이 뛰어나게 발전하여 시프트 연산 방법의 특징은 덜 부각되지만, 여전히 계산 자원을 엄격히 제한해야 하는 환경에서는 고려되고 있다.
RC4
RC4는 lookup table로 불리는 자기 수정 데이터 구조(self-modifying table)를 사용해 키 스트림을 생성한다. 테이블은 항상 1바이트(0, 1, …, 255) 정수의 순열로 구성된다.
이 테이블은 키를 사용해 초기화하고, 각 반복 과정에서 테이블 값을 섞어가며 키 스트림을 생성한다.
- 현재 lookup table의 원소를 서로 교환
- 키 스트림 바이트를 lookup table에서 선택
이렇게 하여 RC4는 각 반복과정에서 단일 바이트 값을 생성한다.
1
2
3
4
5
6
7
8
9
10
11
12
# S = 0, 1, ..., 255의 임의 순열

for i in range(256):
  S[i] = i
  K[i] = key[i % N]
j = 0

for i in range(256):
  j = (j + S[i] + K[i]) % 256
  S[i], S[j] = S[j], S[i]

i = j = 0
각 반복 과정에서 테이블의 원소를 서로 교환하고, 키 스트림 바이트를 lookup table에서 선택한다.
1
2
3
4
5
i = (i + 1) % 256
j = (j + S[i]) % 256
S[i], S[j] = S[j], S[i]
t = (S[i] + S[j]) % 256
key_stream_byte = S[t]
이렇게 하여 키 스트림 바이트를 one-time pad 방법처럼 사용한다. 이 과정에서 첫 256바이트는 사용하지 않고 버린다. 초기화 과정에서 테이블이 충분히 섞이지 않아 키 스트림 연관 공격에 취약하기 때문이다.
Block Cipher
Block Cipher는 고정 크기의 블록 단위로 평문을 암호화한다. 암호문은 평문에 “round function”을 반복 적용하여 생성된다. round function은 키와 이전 라운드 round function의 출력을 입력으로 받아, 혼동과 확산을 발생시킨다.
Feistel Cipher
Feistel cipher는 블록 암호화 구조의 한 종류로, 블록 암호화 방법의 일반화된 설명이다.
이 방법에서는 평문 블록을 반으로 갈라 $P = (L_0, R_0)$ 로 표현, 계산한다. 각 라운드 $i = 1, 2, …, n$ 에 대해
\[L_i = R_{i - 1}\] \[R_i = L_{i - 1} \oplus F(R_{i - 1}, K_i)\]$F$ 는 round function, $K_i$ 는 각 라운드에 사용하는 서브키*이다.
* 일반화하여 이렇게 표현되었다. 전체 과정에서 사용하는 키 자체가 아니라, 이 키로부터 어떠한 방법으로든 파생되어 각 라운드에서만 사용되는 키를 지칭한다.
\[C = (L_n, R_n)\]위 과정으로 암호화하면 복호화는 그 역과정을 거쳐 처리할 수 있다.
\[C = (L_n, R_n)\]각 라운드 $i = n, n - 1, …, 1$ 에 대해
\(R_{i - 1} = L_i\) \(L_{i - 1} = R_i \oplus F(L_i, K_i)\)
를 반복하면 평문 $P$ 를 획득할 수 있다.
\[P = (L_0, R_0)\]Substitution-Permutation Network
살펴보았듯, Substitution(치환)과 Permutation(전치)를 반복하면 평문과 키 사이의 관계를 복잡하게 만들어 연관성을 알기 어렵게 할 수 있다. 이 원리를 두고 Substitution-Permutation Network(SPN, S-P net)라고 한다.
S-P net은 두 개의 암호화 연산으로 구성된다고 이해할 수 있다.
- S-box: substitution
- P-box: permutation
DES
AES
Advanced Encryption Standard 참조
Block Cipher Modes of Operation
여러개 블록을 암호화하기 위해 블록마다 새로운 키를 생성할 필요는 없다. 아날로그 방법의 코드북에서 additive 방법을 사용하듯, 하나의 키를 사용하면서 블록마다 실질적으로 다른 키를 사용해 암호화할 수 있다.
- ECB: Electronic Codebook mode
- 각 블록을 독립적으로 암호화함.
- 가장 단순한 방법이고, 가장 덜 암호화됨.
- CBC: Cipher Block Chaining mode
- 블록을 함께 체인하여 암호화한다.
- ECB보다는 안전하면서, 추가로 더 필요한 작업은 거의 없음.
- CTR: Counter mode
- 블록 암호화가 스트림 암호화처럼 동작함.
- 랜덤 액세스가 가능해 널리 쓰임.
ECB(Electronic Codebook) Mode
\[C = E(P, K)\]ECB 모드는 주어진 평문 블록 $P_i = P_0, P_1, … P_m, …$ 에 대해 각 블록을 개별적으로 암호화한다.
| Encrypt | Decrypt |
|---|---|
| $C_0 = E(P_0, K)$ | $P_0 = D(C_0, K)$ |
| $C_1 = E(P_1, K)$ | $P_1 = D(C_1, K)$ |
| $C_2 = E(P_2, K)$ | $P_2 = D(C_2, K)$ |
| … | … |
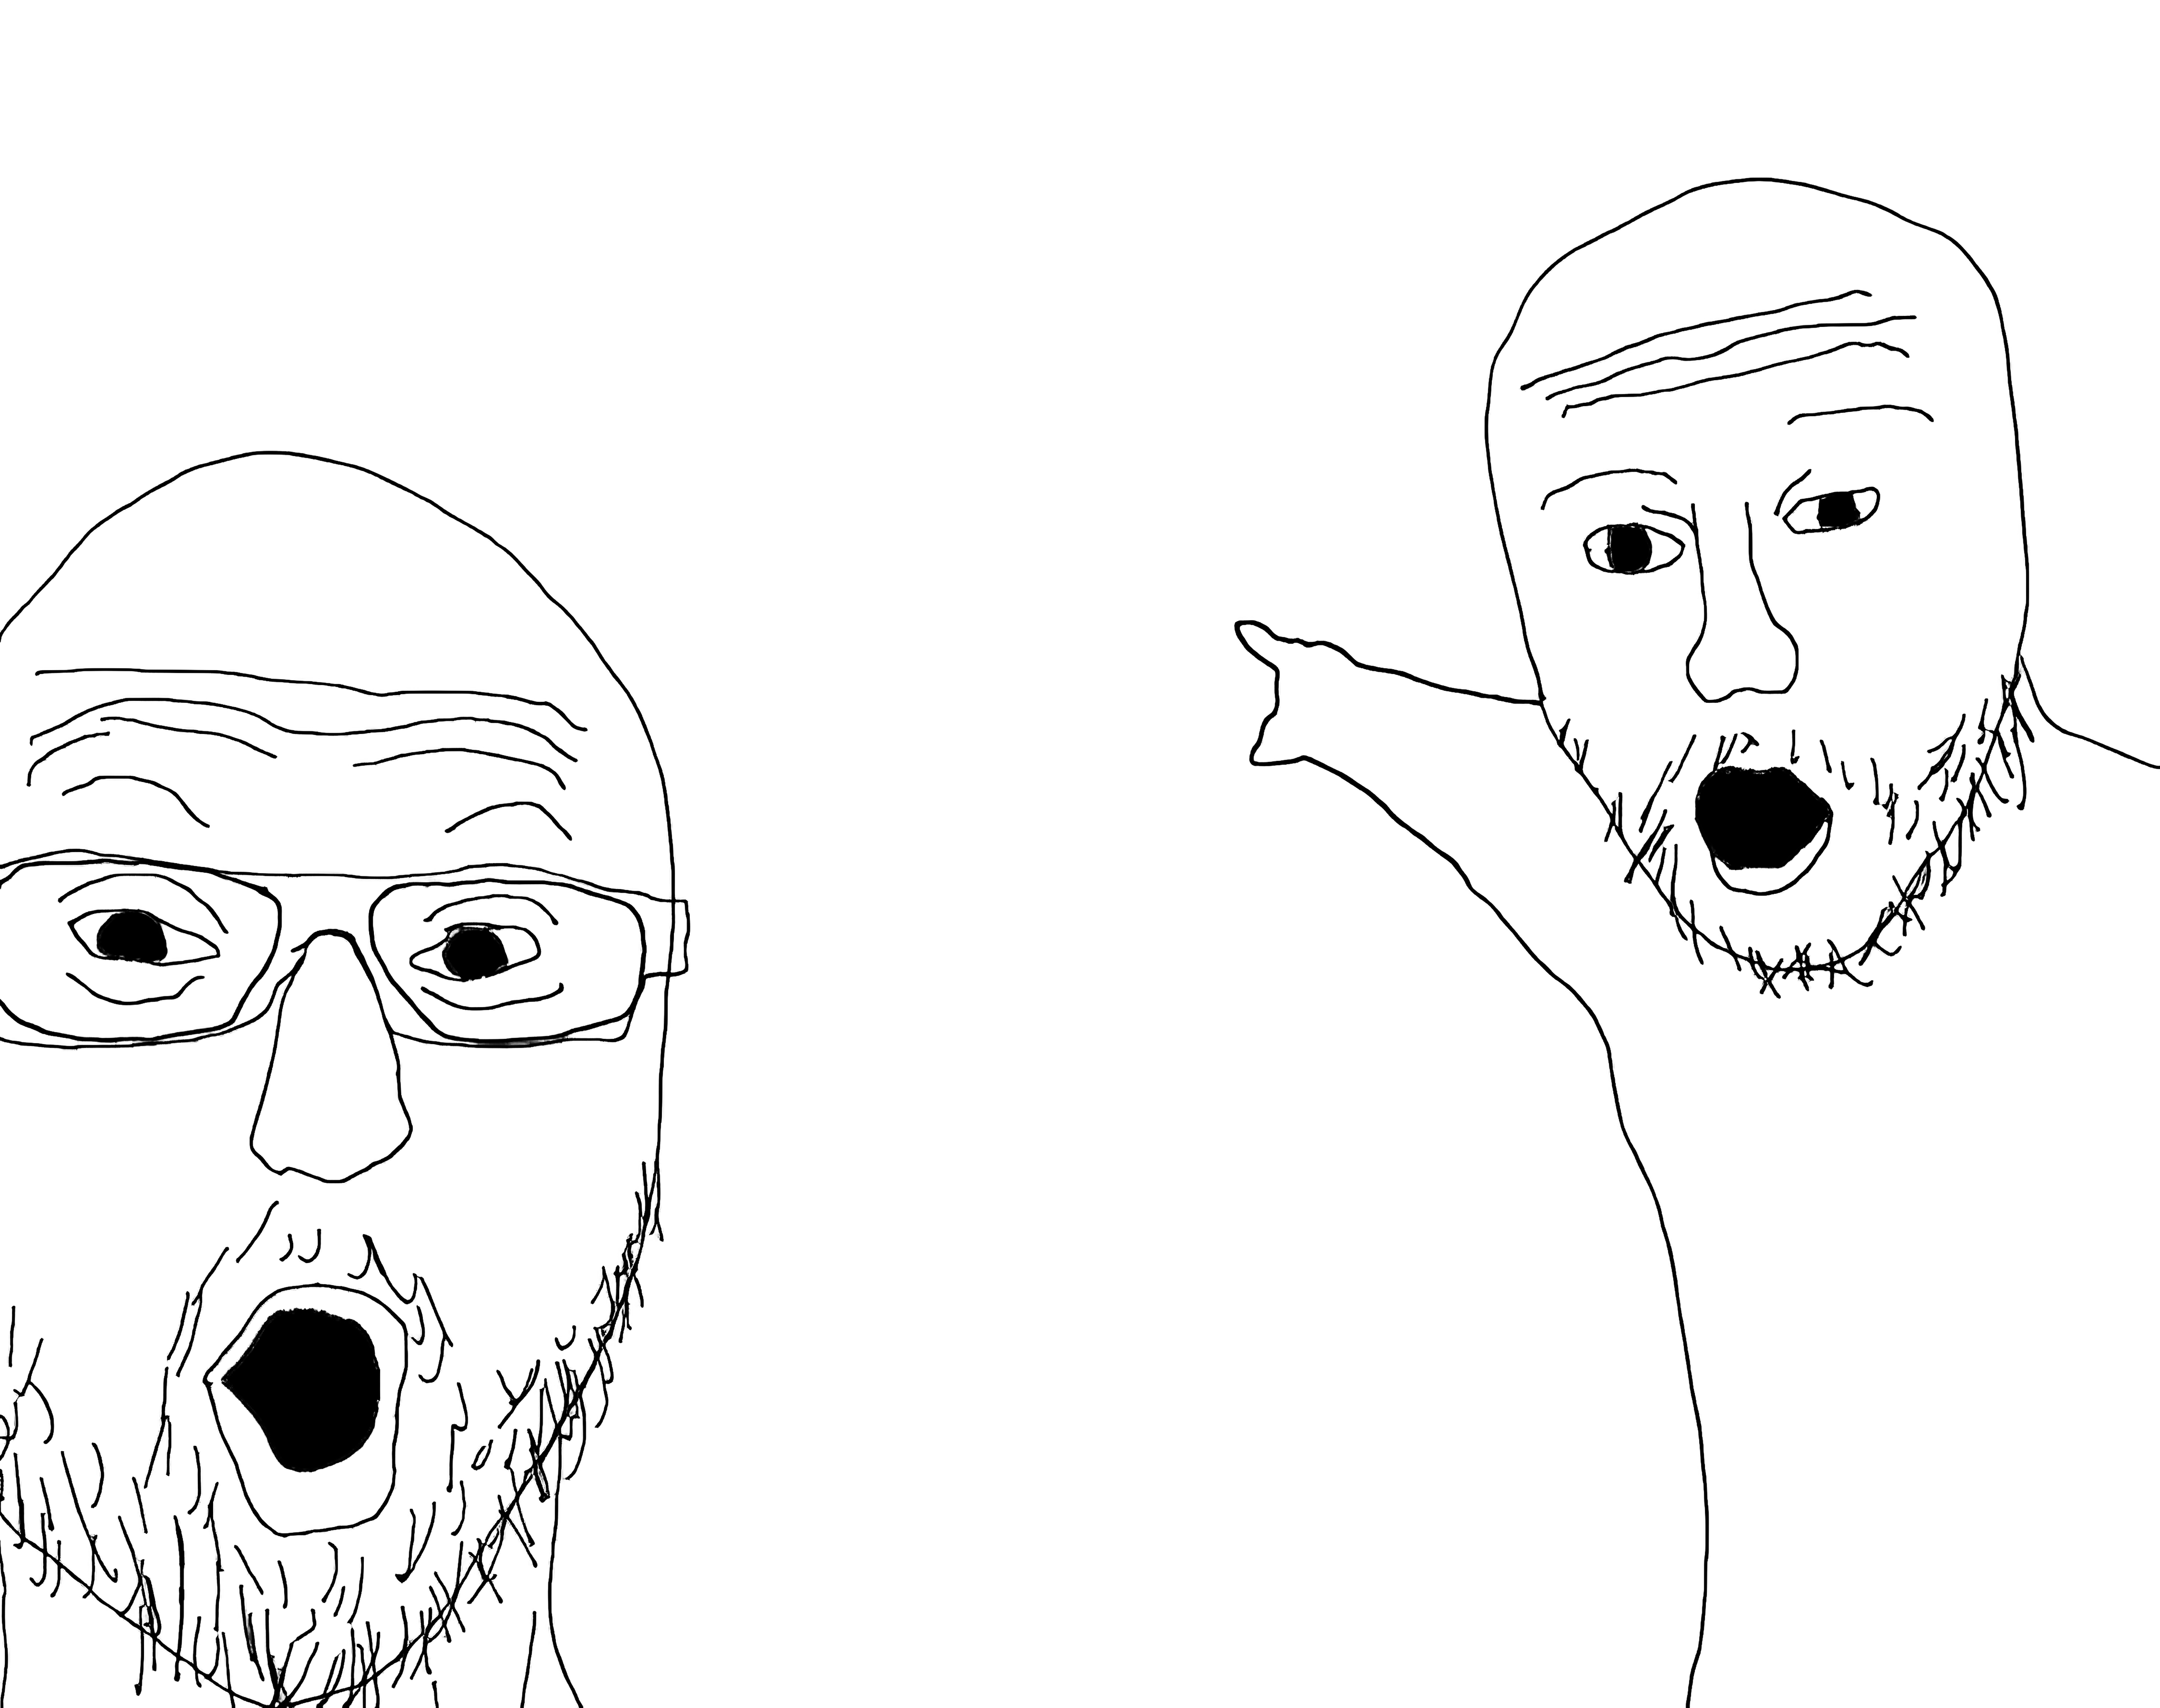
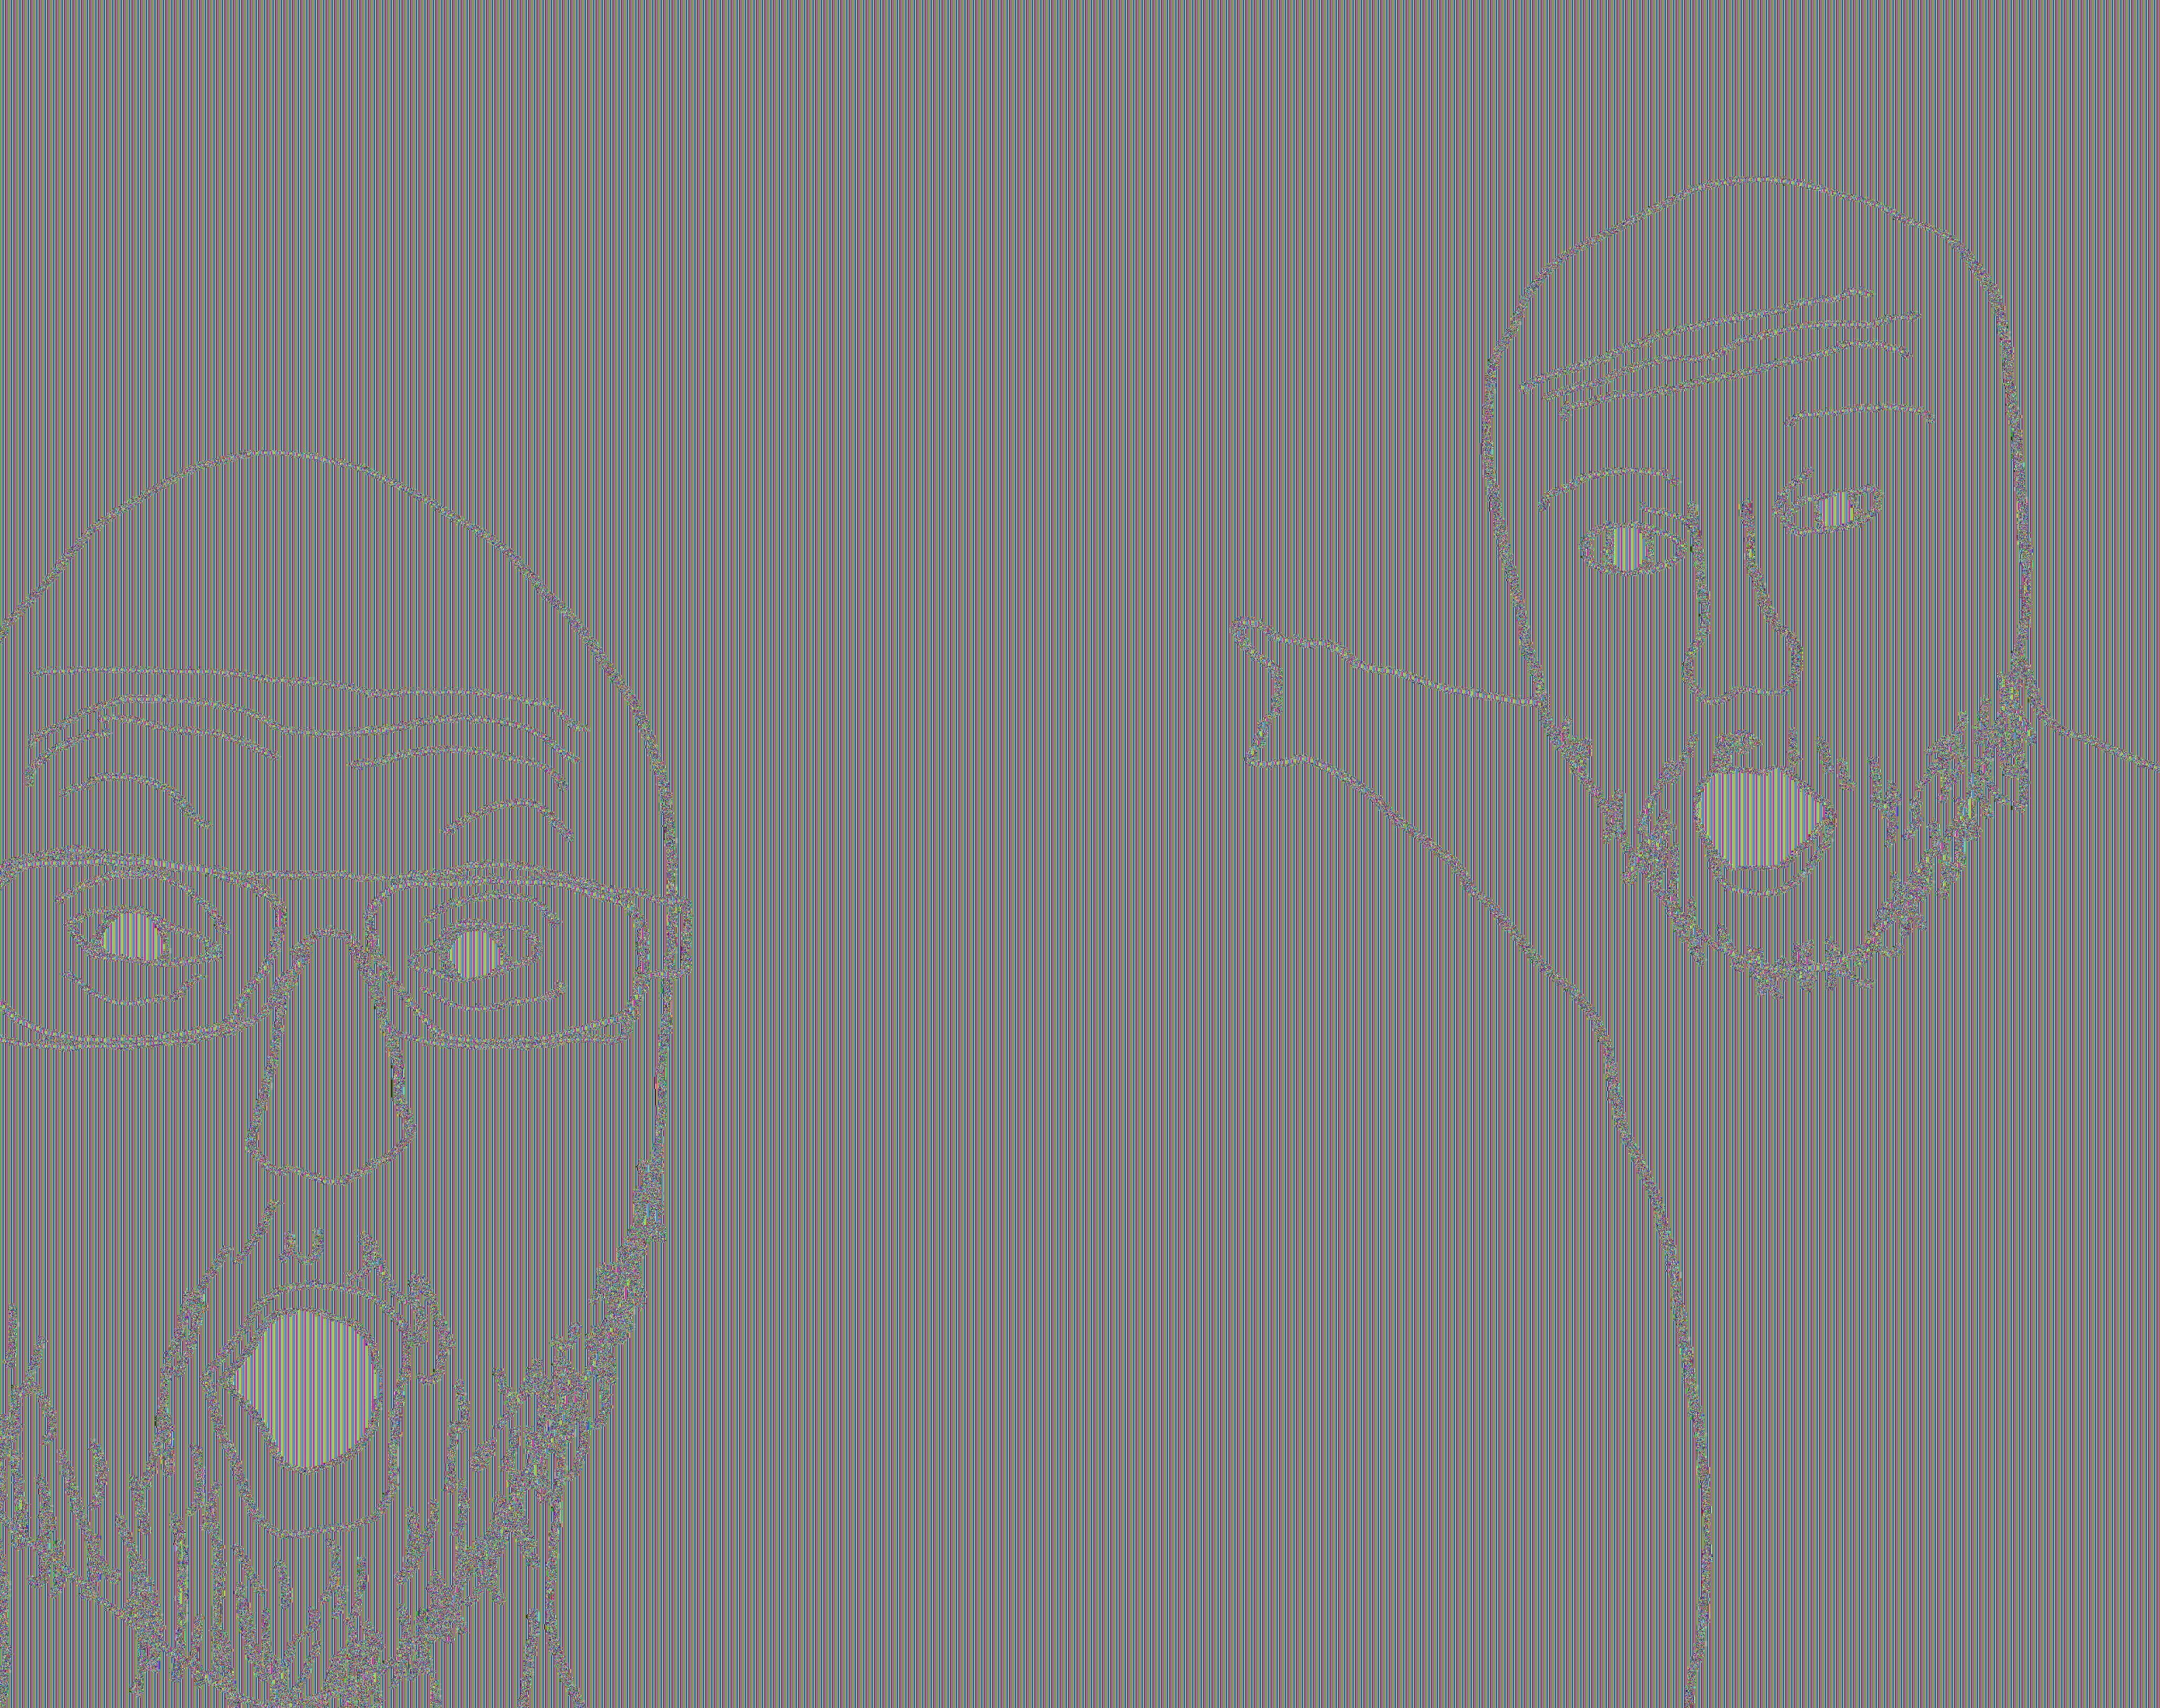
이 방법은 additive 방법이 없는 코드북 암호화의 전자적 구현이다. 각 블록을 독립적으로 암호화하기 때문에, 동일한 평문 블록은 동일한 암호문 블록으로 암호화된다. 따라서, 평문 블록의 반복 패턴이 그대로 암호문에 나타나게 된다.
\[C_i = C_j \iff P_i = P_j\]| Plaintext | Ciphertext |
|---|---|
 |  |
CBC(Cipher Block Chaining) Mode
CBC 모드는 각 블록을 암호화할 때 이전 블록의 암호문을 사용하여 암호화한다. 각 블록은 이전 블록과 연결되어있다. 이 방법은 additive한 코드북 암호화 방법과 유사하다.
| Encrypt | Decrypt |
|---|---|
| $C_0 = E(P_0 \oplus IV, K)$ | $P_0 = D(C_0, K) \oplus IV$ |
| $C_1 = E(P_1 \oplus C_0, K)$ | $P_1 = D(C_1, K) \oplus C_0$ |
| $C_2 = E(P_2 \oplus C_1, K)$ | $P_2 = D(C_2, K) \oplus C_1$ |
| … | … |
첫 번째 블록은 이전에 암호화된 블록이 없기 때문에 랜덤으로 생성된 데이터 $IV$ (Initial Vector)를 사용해 암호화한다. 이 벡터는 랜덤하게 생성되지만 비밀 값은 아니다.
이 방법으로는 동일한 평문 블록이 나타난다고 하더라도 암호화 결과는 달라진다. 평문 블록의 패턴이 암호문에 그대로 나타나지 않는다.
| Plaintext | Ciphertext |
|---|---|
|  |
하지만 CBC 모드는 블록 간의 의존성을 가지기 때문에, 하나의 블록이 손상되면 이어지는 블록도 영향을 받을 수 있다.
$C_1$ 의 손상된 블록 $G$ 를 수신한다면 $C_2$ 에 대한 복호화 결과는 $P_2$ 가 아니다.
\[P_1 \ne C_0 \oplus D(G, K), \quad P_2 \ne G \oplus D(C_2, K)\] \[P_3 = C_2 \oplus D(C_3, K), \quad P_4 = C_3 \oplus D(C_4, K)\]하지만 이후의 블록에는 오류가 영향을 미치지 않는다. $P_3$ 부터는 정상적으로 복호화된다.
CTR(Counter) Mode
CTR 모드는 랜덤 액세스가 가능해 널리 쓰이는 방법이다. 블록 암호화를 스트림 암호화처럼 동작하게 한다. 각 블록은 카운터 값을 사용하여 암호화된다.
| Encrypt | Decrypt |
|---|---|
| $C_0 = P_0 \oplus E(IV, K)$ | $P_0 = C_0 \oplus E(IV, K)$ |
| $C_1 = P_1 \oplus E(IV + 1, K)$ | $P_1 = C_1 \oplus E(IV + 1, K)$ |
| $C_2 = P_2 \oplus E(IV + 2, K)$ | $P_2 = C_2 \oplus E(IV + 2, K)$ |
| … | … |
CTR 모드는 각 블록이 독립적으로 암호화되기 때문에, 블록의 순서와 상관없이 암호화-복호화가 가능해 병렬 처리할 수 있다.