하드웨어 과적합 접근으로 Mass Spring Damper 시스템 최적화하기
도입
기말고사를 ‘본인만의 수치적분법(Numerical Integration)을 물리 시뮬레이션에 적용하는 텀프로젝트’로 대체합니다.
…
평가 기준 시뮬레이션의 완성도는 아래 3가지 항목을 기준으로 평가하며, 만족도가 높을수록 고득점을 부여합니다.
- 시간 간격(Time-step)의 강인성: 타임스텝이 커져도 시뮬레이션이 터지지 않고 안정적으로 유지되는가
- 강성(Stiffness)의 강인성: 높은 강성 값에서도 수치적 불안정성 없이 안정적인 거동을 보이는가
- 거동의 사실성: 실제 물리 현상과 얼마나 유사하고 사실적으로 표현되는가
평가 시나리오 (총 3개) 제공된 템플릿 프로젝트 내의 모든 시나리오(총 3종)에서 본인의 수치적분법이 정상 작동하고 위의 평가 기준을 만족해야 합니다.
- 천(Cloth) 시뮬레이션: 중력(Gravity) 조건 하에서만 구동 및 평가
- 볼륨 메쉬(Volume Mesh) 시뮬레이션: 중력(Gravity) 조건 하에서만 구동 및 평가
- 1자유도(1-DoF) 스프링 시뮬레이션: 사용자 입력(User Input)에 따른 외력이 작용하는 상태에서 구동 및 평가
… (후략)
학교의 가상현실 수업에서 Mass-Spring-Damper 시스템의 수치적분 계산을 수단과 방법을 가리지 않고 최적화하는 기말고사 대체과제를 수행하였다. 수치적분 수식의 구성 요소를 수정해도 되고, 새로운 수치적분법을 고안하거나, 아예 새로운 제 3의 접근을 시도해도 되었다.
이 과제에 대해서 최적화 대상을 특정한 하드웨어, 이 과제에서는 프로젝트를 시연할 컴퓨팅 환경으로 고정하고, 그 하드웨어에 대해서만 과하게 최적화하는 방법으로 작업을 수행하였다.
이러한 방법은 하드웨어가 고정된 플랫폼의 소프트웨어를 개발할 때 유용하게 쓰인다. 예를 들어 콘솔 게임기의 하드웨어 스펙이 일반적인 게이밍 PC보다 낮음에도 불구하고, 콘솔 게임은 PC에 준하거나 그보다 나은 성능을 보인다. 이는 콘솔 게임기의 하드웨어에 맞춰 최적화된 소프트웨어를 개발했기 때문이다.
단일 플랫폼(좋은 예로 Xbox가 있습니다)으로 수년간 일했던 개발자가 있다고 합시다. 수년이라면 해당 플랫폼에서 통하는 흑마법을 익히기에 충분합니다.
《C++ 최적화》, 커트 건서로스 저(옥찬호 역), 2019.
따라서 하드웨어를 고정했다는 전제 하에, 시연이 이루어질 컴퓨팅 환경, AMD Ryzen 5 5600 6-Core Processor (12 CPUs), ~3.5GHz, NVIDIA GeForce RTX 3050 (VRAM 8GB), 32GB 메모리 환경에 대해 Mass-Spring-Damper 시스템의 수치적분 계산을 최적화했다.
과제 템플릿으로써 주어진 것은 변형 없이 개념 그대로의 Explicit Euler Method를 사용한 C# MonoBehaviour 구현이었다. MonoBehaviour는 일반적으로 CPU에서 동작하므로, 이 시도에서는 GPU를 사용하도록 하고, RTX 3050의 하드웨어 스펙에 맞춰 계산 동작을 수행하도록 최적화했다.
배경
물리 계산 기반 그래픽 렌더링 방법에서는 물리 시뮬레이션을 계산하면서 위치 $x$, 속도 $\dot{x}$, 가속도 $\ddot{x}$ 를 계산한다. 이 방법에서는 대개 $\ddot{x}$ 로부터 $\dot{x}$ 를, $\dot{x}$ 로부터 $x$ 를 계산하게 되면서, 적분 계산 처리가 요구된다.
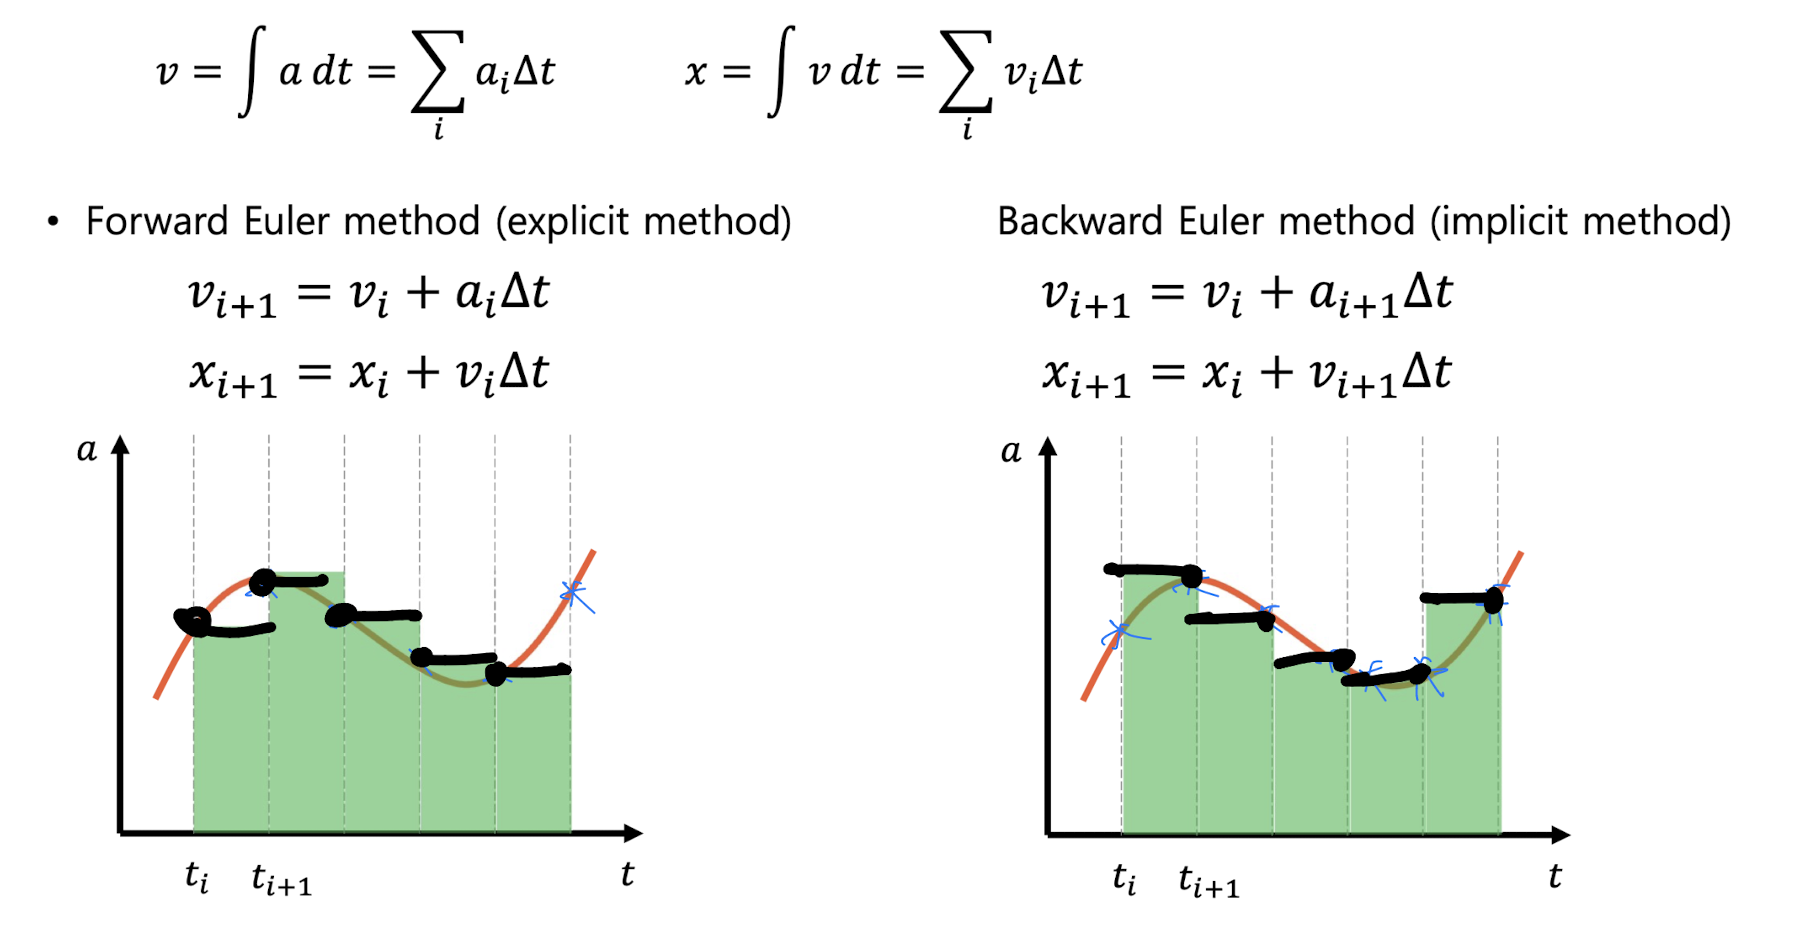
문제는 컴퓨터에서는 수학적 의미에서의 적분을 정확하게 수행할 수 없다는 점이다. 컴퓨터에서는 연속한 값을 다룰 수 없으므로, 연속 값을 잘게 쪼개어 계산하는 수치적분법(Numerical Integration)을 사용하게 된다.
하지만 수치적분법은 결국 연속값을 근사하는 것이므로, 실제 기대값과 오차가 발생할 수밖에 없다. 만약 시스템에서 오차가 적절히 해결되지 않고 점차 누적된다면 시뮬레이션은 불안정해지고 이윽고 모델이 터져나가는 것처럼 보이게 된다.
이러한 상황을 막기 위해서는 오차가 최대한 적은 수치적분법과 연속값을 더욱 최대한 잘게 쪼개는 방법을 사용해야하나, 필연적으로 연산량이 많아지고 계산속도가 매우 느려지게 된다. 특히 초당 최소 30프레임 이상은 보장해야 하는 현대의 게임 환경이나 실시간 가상현실에서 이러한 단점은 매우 치명적이다.
따라서 실제로는 렌더링에서 물리 시뮬레이션을 대신 다른 방법을 채택하거나, 이 수치적분 식을 변형하여 새로운 수치적분법을 정의해 오차를 최소화하려고 한다.
방법론
이 작업에서는 발산 문제로부터 상대적으로 자유로운 Implicit Euler Method를 사용하도록 수치적분법을 변형했다. Implict Euler Method을 사용하면서 대응해야 할 것에는 높은 컴퓨팅 비용이 있었다.
Implict Euler Method의 높은 컴퓨팅 비용은, 렌더링 타이밍으로부터 물리 계산 타이밍을 분리하여 선형 보간하도록 하고, MonoBehaviour 구현으로 CPU에서 동작하게 되는 렌더링 로직을 GPU를 사용하도록 수정하였으며, 이 렌더링 처리를 RTX 3050에 맞게 튜닝하여 RTX 3050에서 성능 개선을 획득할 수 있도록 해, 런타임이 감당 가능하도록 완화하였다.
이 작업 구현의 최적화 대상 PC 환경은 다음과 같다.
| 항목 | 사양 |
|---|---|
| CPU | AMD Ryzen 5 5600 6-Core Processor (12 CPUs), ~3.5GHz |
| RAM | 32GB |
| GPU | NVIDIA GeForce RTX 3050 (VRAM 8GB, GA106, Compute Capability 8.6, L2 2MB) |
| OS | Windows 11 Education |
렌더링 타이밍으로부터 물리 계산 타이밍 분리
Implicit Euler는 한 스텝마다 선형 시스템을 풀어야 하므로, 모든 물리 틱에서 실행하면 비용이 빠르게 커진다. 따라서 이 구현은 매 틱마다 적분하지 않는다. GetFramesSkippingCompute(timeStep)가 계산을 건너뛸 횟수 $n$을 정하고, FixedUpdate가 $n+1$회 호출되는 동안 실제 적분은 처음 한 번만 수행한다. 나머지 호출에서는 이미 계산해 둔 두 상태 사이를 선형보간하여 메시만 갱신한다.
엄밀히 말하면 여기서 분리한 대상은 Unity의 Update 렌더 콜백과 물리 계산이 아니다. 현재 구현에서 Update는 Time.fixedDeltaTime과 측정값을 갱신하고, 적분과 UpdateVisualMesh 호출은 모두 FixedUpdate에서 일어난다. 즉 고정 시간 간격의 물리 틱 안에서 비싼 적분 빈도와 메시를 갱신하는 빈도를 분리한 것이다. 실제 화면 표시 시점은 이후 Unity 렌더링 파이프라인이 결정한다.
계산 틱에는 먼저 현재 파티클 위치를 previousSimulatedPositions에 복사한다. 그 뒤 CUDA 또는 C# Implicit Euler로 다음 상태를 계산해 currentSimulatedPositions에 저장한다. 메시 갱신은 다음 식의 $\alpha$를 사용한다.
여기서 interpolationStepCount = n + 1이다. 계산 직후에는 $\alpha=1/(n+1)$이고, 건너뛴 틱마다 한 단계씩 증가하여 다음 계산 직전에는 $\alpha=1$이 된다. 따라서 파티클의 내부 상태는 다음 적분 결과로 즉시 진행하지만, 화면 메시는 이전 결과에서 새 결과까지 여러 틱에 걸쳐 이동한다. 이 방식은 메시의 갱신을 멈추지 않으면서 solver 호출 수를 $1/(n+1)$ 수준으로 낮춘다.
건너뛴 틱 수만큼 시뮬레이션 시간이 느려지지 않도록, 실제 적분에 전달하는 시간 간격도 확대해야 한다. 구현의 C# 경로 IntegrateImplicitEuler와 CUDA 경로 TryStepNativeImplicit은 모두 다음의 유효 시간 간격을 사용한다.
예를 들어 timeStep = 0.01이면 GetFramesSkippingCompute는 $n=2$를 반환한다. 따라서 3회의 FixedUpdate마다 한 번 적분하고, 적분에는 $0.03\,\mathrm{s}$를 사용하며, 메시는 $1/3$, $2/3$, $3/3$의 비율로 보간된다. $n$만 곱하면 이 경우 $0.02\,\mathrm{s}$만 진행되어 시뮬레이션 시간이 실제 시간의 2/3 속도로 흐르므로, 반드시 $n+1$을 사용해야 한다.
이 기법은 화면상 갱신 빈도와 solver 호출 횟수에 직접 영향을 준다. 그러므로 아래 CUDA 커널 최적화의 성능을 평가할 때에는 계산 생략 및 보간을 적용한 효과와 커널 자체의 효과를 분리해 측정해야 한다. 또한 적분 구간을 넓히는 대가로 한 스텝의 수치 오차 특성도 달라지므로, 프레임레이트뿐 아니라 동일한 유효 시간 간격에서의 안정성과 거동도 함께 확인해야 한다.
RTX 3050 (8GB) 과적합 최적화
CG 반복에서 발생하는 호스트 동기화 제거
Conjugate gradient(CG) 반복에서 계산하는 $\alpha$, $\beta$, breakdown 플래그는 모두 디바이스 메모리의 스칼라 슬롯에 둔다. 내적의 reduction 결과를 호스트로 복사해 이 계수를 계산하면, 복사 지점마다 CUDA 스트림이 동기화되어 GPU의 작업 대기열이 끊긴다.
각 계수는 reduction 커널에서 합계를 얻은 스레드가 바로 계산한다. CG 반복 전체를 호스트 개입 없이 CUDA 작업 대기열에 적재하고, 호스트는 일정한 반복 묶음이 끝난 뒤에만 잔차를 확인한다. 이미 수렴한 상태에서 몇 회를 더 반복하는 비용보다, 매 반복마다 파이프라인을 비우는 비용이 훨씬 크기 때문이다.
커널 런치 횟수 축소
이 시스템에서는 커널 하나가 수 마이크로초 안에 끝나므로, 호스트가 커널을 작업 대기열에 넣는 과정도 유의미한 비용으로 고려할 수 있다. 따라서 CG 반복은 역할이 이어지는 점별 연산을 하나의 커널에 결합하여, 반복당 여섯 번의 커널 실행으로 구성한다.
- 내적 2단계 reduction 커널은 합계를 얻은 스레드에서 $\alpha$ 또는 $\beta$까지 계산한다.
- 잔차 갱신 커널은 갱신 직후의 잔차로 $r \cdot r$ 부분합도 계산한다.
- 탐색 방향 $p$ 갱신 커널은 다음 반복에 사용할 질량 항 $M p$를 함께 기록한다. 행렬-벡터 곱은 스프링 항을 누적하는 커널로 완성한다.
- 힘 초기화 커널은 초기 상태 $x_0$, $v_0$도 함께 저장한다.
float4 사용
NVIDIA GPU의 어셈블리 명령어에는 128비트의 데이터를 한 번에 로드할 수 있는 LDG.E.128 명령어가 있다. 만약 float 값을 4개 로드해야 한다면, 32비트 데이터를 로드하는 LDG.E.32 명령을 4회 호출하는 것 대신 128비트 로드 명령을 1회 호출하는 것이 처리량을 더 높일 수 있다.
float4 데이터 타입은 16바이트(128비트)로 크기로 구성된 벡터 타입으로, 이 데이터 타입을 사용하면 위의 LDG.E.128(store는 STG.E.128) 명령으로 컴파일된다. 주소가 16바이트에 맞춰 정렬되어있고, 접근 패턴이 연속적이라면, GPU는 메모리 접근을 벡터화하여 128비트 단위로 데이터를 고속으로 읽고 쓸 수 있다. 12
다만 이 이득이 어디에서 발생하는지는 구분해야 한다. 위 설명의 전제인 ‘접근 패턴이 연속적’이라는 조건은 파티클 인덱스를 순차적으로 순회하는 점별 연산 커널에서만 성립한다. 스프링 커널은 스프링의 양 끝점 인덱스를 경유해서 위치를 읽으므로 접근이 연속적이지 않고, 캐시 라인 활용률도 낮아진다. 또한 이 구현은 w 성분을 사용하지 않으므로 메모리의 25%가 패딩으로 소비된다. 대역폭에 제약되는 워크로드에서는 이 낭비가 벡터화 이득을 상쇄할 수 있다.
스레드 당 레지스터 사용량 제한(__launch_bounds__)
Mass-Spring-Damper 시스템의 계산 커널에서 Point-wise 연산을 많이 사용하였다. Point-wise 연산은 각 원소에 대해 독립적으로 수행되어, 메모리 접근 패턴이 단순하고 병렬화하기 쉽다. 그러나 여러 개의 Point-wise 연산이 하나의 커널 안에서 연속적으로 수행되면, 각 중간 계산값을 저장하기 위해 스레드당 필요한 레지스터 수가 증가할 수 있다.
GPU에서 레지스터는 각 스레드가 가장 빠르게 접근할 수 있는 저장 공간이다. 따라서 중간 변수나 반복적으로 사용되는 값들을 레지스터에 저장하면 메모리 접근 비용을 줄일 수 있다. 하지만 레지스터는 Streaming Multiprocessor(SM)마다 사용할 수 있는 레지스터 파일의 크기가 제한되어 있다. 한 스레드가 사용하는 레지스터 수가 많아질수록 하나의 SM에 동시에 배치될 수 있는 스레드, 워프의 수는 줄어든다.
주목할 점은 RTX 3050의 SM당 레지스터 파일 크기가 64K개의 32-bit 레지스터라는 점이다. 이는 한 SM에서 동시에 실행되는 모든 스레드가 공유하는 레지스터 자원이다. 예를 들어, 하나의 스레드가 사용하는 레지스터 수가 적다면 더 많은 워프가 동시에 SM에 상주할 수 있다. 반면, 스레드당 레지스터 사용량이 커지면 동일한 64K 레지스터 파일 안에서 수용 가능한 스레드 수가 감소하게 된다.
이것은 GPU의 병목으로 발전할 수 있다. 하나의 SM에서 동시에 실행되는 워프 수가 적으면, 메모리 접근이나 연산이 완료될 때까지 기다리는 동안 다른 워프가 실행되지 못해 GPU의 유휴 시간이 증가한다. 이어서 전체적인 처리량을 감소시키고, 결과적으로 성능 저하로 이어진다.
__launch_bounds__는 커널의 레지스터 부하에 따라 다르게 지정한다. 점별 연산 커널과 reduction 커널은 스레드당 레지스터 사용량이 낮으므로, SM당 여섯 블록, 즉 1536스레드가 상주하도록 최대 점유율을 목표로 한다.
반면 스프링 커널은 두 끝점의 위치와 속도, 방향 벡터와 여러 스칼라를 동시에 유지하므로 레지스터 압박이 크다. 이 커널에는 SM당 네 블록, 1024스레드를 지정한다. 최대 점유율을 강제해 local memory 스필이 발생하는 상황을 피하면서, 간접 메모리 접근의 지연을 숨길 만큼의 워프를 확보하기 위한 선택이다.
읽기 전용 데이터로 플래그 (__ldg)
커널 실행 중 값이 변하지 않는 입력 버퍼, 예컨대 rest length, 질량 등은 읽기 전용 접근으로 취급할 수 있다. 이들에 대해 const __restrict를 부여하고, __ldg()를 사용해 read-only data cache load 경로를 사용하도록 힌트하였다. 컴파일러가 읽기 전용 조건이 충족되는지 감지하도록 하는 데 있어 __ldg를 사용하면, 조건을 검사해 L1 캐시를 활용하도록 유도할 수 있다.34
L2 persisting cache limit 설정 (cudaDeviceSetLimit)
Mass-Spring-Damper 시스템의 implicit 적분 경로는 conjugate gradient(CG) solver를 반복 수행하면서, 동일한 상수 데이터—스프링 양 끝점 인덱스, 선형화 계수, 질량, 각 점의 상태 표현 마스크—를 매 반복마다 다시 읽는다. 이 데이터는 한 스텝 동안 값이 바뀌지 않으므로, 매 CG 반복 과정에서 메모리까지 다시 내려가 읽는 대신 L2 캐시에 머무르게 할 수 있다면 메모리 지연과 대역폭 압박을 크게 줄일 수 있다.5
RTX 3050이 기반하는 NVIDIA Ampere 아키텍처는 L2 캐시 내 데이터 잔류(residency)를 제어할 수 있다. 이 구현은 persisting cache 예산을 L2 전체 용량의 고정 비율로 정하지 않고, 실제로 상주시킬 버퍼의 크기에서 산정한다.6
cudaDeviceSetLimit은 L2에서 persisting 용도로 사용할 수 있는 영역의 크기를 정한다. 대상 버퍼가 실제로 이 영역을 우선 사용하도록, 대상 주소 범위에는 cudaAccessPolicyWindow의 hitProp = cudaAccessPropertyPersisting 접근 정책도 적용한다.
선형화된 스프링 계수 배열은 약 34KB이며, RTX 3050의 L2 캐시 2MB보다 훨씬 작다. 필요 이상의 set-aside 영역을 예약하면 위치, 속도, 잔차 벡터가 사용할 L2 공간만 줄어든다. 따라서 대상 크기를 128KB 단위로 올림하고, 하드웨어 상한 및 L2 용량의 1/4을 넘지 않도록 제한한다. 이 상한은 메시가 커졌을 때 persisting 영역이 캐시 대부분을 점유하지 않도록 한다.
분기에서 비롯되는 제어 해저드 최소화
Mass-Spring-Damper 시스템의 천과 볼륨 메시 시나리오에서는 일부 점을 고정하고 나머지 점만 움직인다. 점이 고정되어 있는지에 따라 분기하면, 하나의 워프 안에서 고정점과 자유점이 섞일 때 branch divergence가 발생할 수 있다.
\[x' = \begin{cases} 0, & \text{if } x \text{ is fixed} \\ x, & \text{otherwise} \end{cases}\]힘 초기화, CG 초기화, 결과 커밋, 내적 부분합, CG 갱신 커널은 고정 여부를 불리언 분기 대신 0 또는 1의 스케일 값으로 계산한다. 고정점에서는 갱신량이 0이 되고, 자유점에서는 원래 식과 같은 갱신량이 계산된다.
내적 계산 중 부분합 처리 (__shfl_down_sync)
시스템의 수치적분 계산에서는 내적 계산이 반복적으로 사용되고 있다. 병렬 처리 효율을 위해 스레드별로 데이터를 분할해 병렬로 내적 처리시킬 수 있는데, 이 때 각 스레드의 곱셈 결과를 합산하는 부분합 reduction 과정이 수행되어야 한다.
warp shuffle을 이용한 reduction
이 과정을 위해 데이터를 공유 메모리로 옮겨 처리할 경우, 공유 메모리에 값을 저장하고 다시 읽는 load/store 연산이 필요하고, 주소를 보관하거나 계산하기 위한 추가 레지스터도 요구되므로 메모리 접근 오버헤드가 발생한다. CUDA에서는 공유 메모리에 접근하지 않고 같은 warp 내부의 다른 lane의 값을 가져올 수 있는 warp shuffle 함수 __shfl_down_sync를 제공한다. 이것을 활용해 부분합 과정의 스레드 간 데이터 교환을 효율적으로 수행할 수 있다.7
블록별 부분합의 후속 reduction
하나의 스레드 블록만으로 전체 입력에 대해 reduction을 수행하려고 하면 블록 하나가 처리할 수 있는 스레드 수의 한계로 인해, 소수의 블록만 실행되어 SM 대부분이 유휴 상태로 남게 된다. 따라서 대규모 데이터 입력을 처리하게 되는 부분을 분리해 위의 __shfl_down_sync를 사용하도록 하고, 이후 각 블록에서 계산된 부분합을 다시 reduction하도록 만들었다.
서로 다른 block의 값을 합산할 때는 __shfl_down_sync를 사용할 수 없다. __shfl_down_sync는 같은 warp 내부 lane 사이의 레지스터 값 교환만 지원하기 때문이다. 따라서 각 block에서 계산한 부분합은 global memory에 저장한 뒤, 별도 커널에서 다시 reduction한다.8
shared memory carveout 설정
RTX 3050과 같은 Ampere 계열 GPU에서는 각 SM의 on-chip memory가 L1 cache와 공유 메모리 두 역할을 모두 수행할 수 있게 하는 unified data cache 구조를 갖는다. CUDA는 이 자원을 커널 단위로 L1 cache와 공유 메모리 중 어느 쪽에 더 많이 배분할지에 대한 선호 설정을 제공한다.910
이 구현의 가장 큰 공유 메모리 사용량은 워프당 float 하나이고, 256스레드 블록에서는 32바이트에 불과하다. 반면 DotPartialKernel은 두 벡터와 마스크를 global memory에서 연속적으로 읽고, 스프링 커널은 인덱스를 경유해 위치를 수집한다. 두 경우 모두 L1 캐시 용량이 중요하므로, 모든 커널에 L1 캐시 선호 설정을 적용했다.
결과
하드웨어 스펙은 최적화 작업을 수행한 후, 각 작업으로부터 획득한 구체적인 최적화 이득은 엄밀하게 평가하지 못했다.
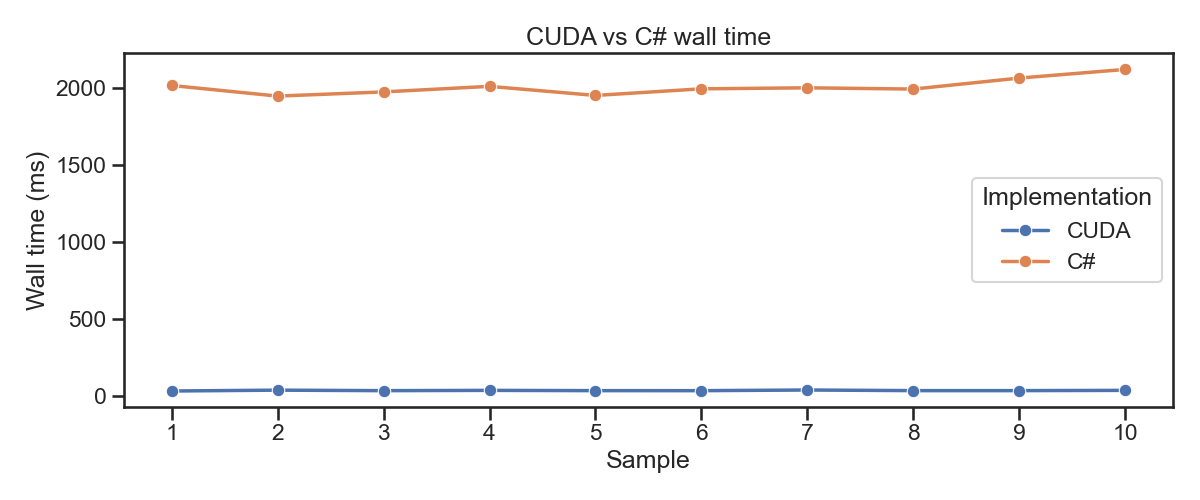
최초에 주어진 Mass-Spring-Damper 시스템의 수치적분 구현에서 유니티 의존성을 제거한 C# 구현과 이 작업물을 벤치하여 대략적인 성능 향상 수준을 측정하긴 하였으나, 두 구현은 매우 큰 차이가 나므로, 각각의 최적화 작업이 얼마나 성능 향상에 기여했는지 자세히 판단하는데 자료로 사용할 수는 없었다. 각 전략의 성능 향상 기여도를 평가했어야 했다는 것이 이 작업에서 앞으로의 과제라고 생각한다.
“5.4.2.3. Built-in Types”, CUDA C++ Programming Guide https://docs.nvidia.com/cuda/cuda-programming-guide/05-appendices/cpp-language-extensions.html#built-in-types ↩
Justin uitjens, Rajeshwari Devaramani, “CUDA 활용 팁: 벡터화된 메모리 접근으로 성능 향상하기”, NVIDIA 테크니컬 블로그 https://developer.nvidia.com/ko-kr/blog/cuda-pro-tip-increase-performance-with-vectorized-memory-access/ ↩
“Global Memory” CUDA C++ Progrmming Guide, https://docs.nvidia.com/cuda/cuda-c-programming-guide/#global-memory-5-x ↩
“Read-Only Data Cache Load Function”, CUDA C++ Programming Guide, https://docs.nvidia.com/cuda/cuda-c-programming-guide/#ldg-function ↩
“4.13. L2 Cache Control” CUDA Programming Guide, https://docs.nvidia.com/cuda/cuda-programming-guide/04-special-topics/l2-cache-control.html ↩
“4.13.4. L2 Persistence Example”, CUDA Programming Guide, https://docs.nvidia.com/cuda/cuda-programming-guide/04-special-topics/l2-cache-control.html#l2-persistence-example ↩
Yuan Lin, Vinod Grover, “Using CUDA Warp-Level Primitives” NVIDIA Technical Blog, https://developer.nvidia.com/blog/using-cuda-warp-level-primitives/ ↩
Mark Harris, “Optimizing Parallel Reduction in CUDA” Optimizing Parallel Reduction in CUDA ↩
“5.3. Memory Hierarchy” CUDA C++ Programming Guide, Release 13.3, https://docs.nvidia.com/cuda/pdf/CUDA_C_Programming_Guide.pdf ↩
“cudaFuncSetCacheConfig, 6.7. Execution Control” CUDA Toolkit Documentation, https://docs.nvidia.com/cuda/cuda-runtime-api/group__CUDART__EXECUTION.html#group__CUDART__EXECUTION_1g6699ca1943ac2655effa0d571b2f4f15 ↩